摘要:自主研发持续提升视频生成表现力与生产效率,助力数字内容产业提质增效。
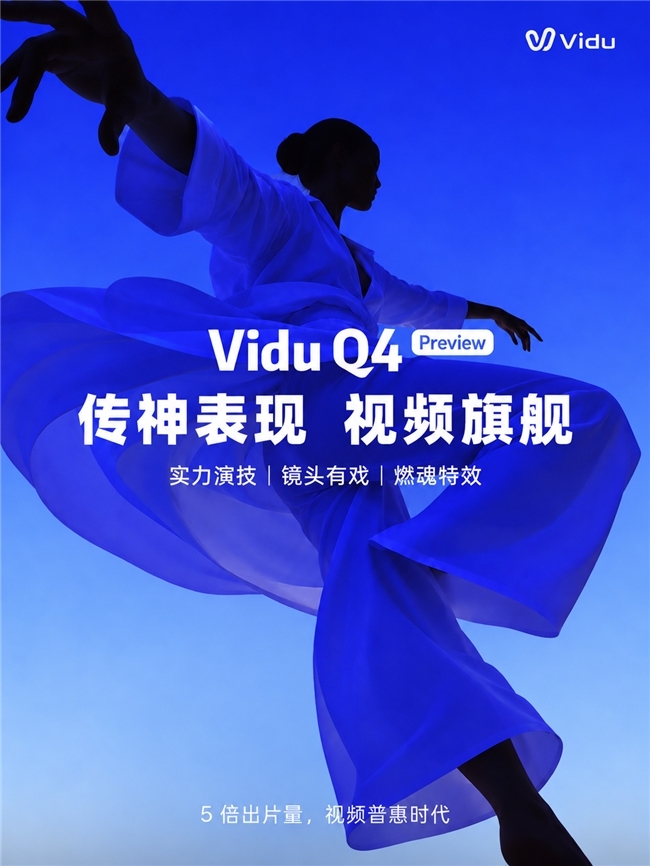
2026年10月8日,北京人工智能企业生数科技发布新一代视频生成旗舰模型首个预览版本Vidu Q4 Preview。
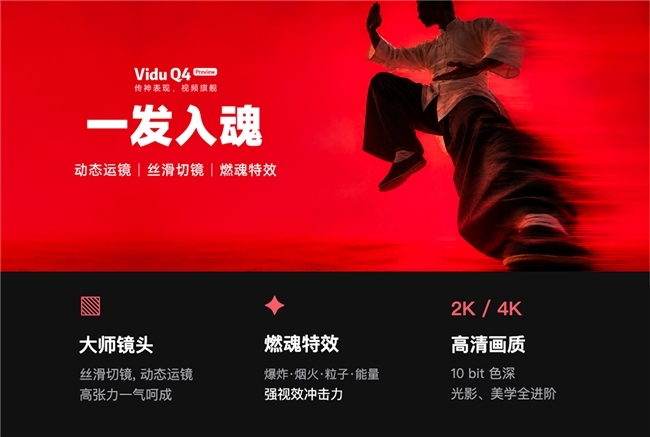
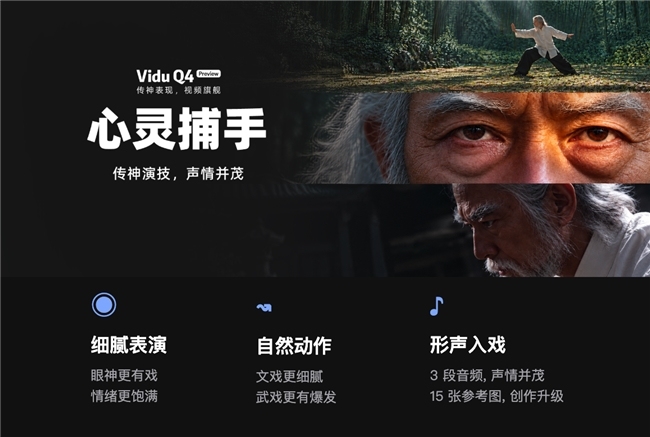
模型围绕人物演绎、镜头语言和复杂视效等能力进一步升级,最多支持15张参考图、3段参考音频,并支持2K、4K输出。产品首发优惠价格为0.09元/秒起,进一步降低视频生成技术的使用门槛。
随着多模态大模型持续演进,我国AI视频产业正在从能力展示加快走向实际生产。生成质量、可控性、推理效率与使用成本的持续优化,有望为影视、动漫、广告、电商、文化传播等领域提供更加高效的数字内容生产工具。
坚持自主创新,持续提升视频生成能力
生数科技长期开展多模态生成与世界模型研究。
2022年,公司核心团队提出创新U-ViT架构;2024年4月,Vidu首次公开亮相,在长时长、高一致性和强动态等方向探索视频生成能力。此后,团队持续推进参考生视频、多主体一致性、声画同出、多镜头叙事和实时交互等技术。
此次发布的Q4 Preview进一步聚焦人物表演、镜头表达和复杂视效。模型加强人物情绪、动作与镜头节奏之间的协同,并通过多图、多音频参考,提高对人物、场景、服装、道具和声音等创作要素的控制能力。
生数科技联合创始人、CEO骆怡航表示:“人工智能技术只有进入真实场景、解决真实问题,才能转化为可持续的生产力。我们希望把模型效率不断转化为更低的使用门槛,让更多个人、团队和企业能够用得上、用得起。”
降低应用成本,提升数字内容生产效率
视频创作通常需要经过多轮试拍和版本比较,生成成本直接影响创作者的尝试空间和企业应用效率。
Vidu Q4 Preview首发优惠价格为0.09元/秒起,提供多种输出规格。在可比规格和计费条件下,同等预算最高可生成5倍内容。
生成成本和效率的改善,有利于AI视频进一步进入实际生产流程。
在广告、电商领域,企业可以围绕不同产品、渠道和目标人群快速测试创意素材;在漫剧、短剧和影视制作中,创作团队可以提前进行分镜预演、人物调度和镜头验证;在文旅、教育等领域,AI视频也可以为数字内容生产提供新的表达方式。
骆怡航表示,视频生成技术普惠并不只是降低单次生成价格,更重要的是通过模型、推理和工程效率的持续优化,把技术进步转化为创作者更多的试错空间和企业更可持续的生产效率。
推动文化与科技融合,拓展产业应用
随着人工智能与文化产业加快融合,AI正在从创意辅助工具逐步进入内容生产流程。
目前,生数科技已与影视、内容平台、云计算等产业伙伴开展合作,在AI视听创制、漫剧生产、企业API接入等方向推进应用,并形成覆盖SaaS、MaaS、Agent服务等形态的视频生成产品与服务体系。
同时,生数科技持续推动自主研发的多模态生成技术面向全球市场落地,为数字内容创作、产业生产和跨区域服务提供新的技术支撑,也为中国人工智能技术与数字内容能力拓展海外应用场景提供新的实践。
坚持规范发展,推动技术普惠
随着人工智能生成内容加快普及,版权保护、肖像和声音授权、内容安全以及服务稳定性等问题也受到更多关注。
生数科技表示,在推进模型开放和产业应用的同时,将持续完善技术治理和产品机制,明确预览版本的能力边界和适用范围,推动生成式人工智能规范、健康发展。
当前,Vidu Q4 Preview仍处于预览阶段。生数科技将通过真实用户使用和项目反馈持续优化模型,为后续正式版本迭代提供依据。
随着基础模型能力、推理效率和产业配套不断完善,AI视频正从创意辅助加快进入数字内容生产流程,为文化产业数字化和数字经济发展提供新的技术工具。
开创世界模型发展五级路线,从数字内容走向物理AI
生数科技提出通用世界模型五级发展路线,推动模型能力从高质量视觉内容生成,逐步向时空一致性理解、实时交互、物理规律模拟及自主决策演进,构建连接数字内容生产与物理AI应用的技术体系。
其中,Q系列作为通用世界模型的基础底座,此次Q4 Preview的推出,不仅实现了视频生成质量与时空一致性的进一步突破,也将持续增强S系列和Motubrain系列的底层能力。一方面,赋能S系列在L2、L3阶段的实时生成、动态交互与世界一致性能力;另一方面,提升Motubrain系列对真实物理世界的理解、模拟与预测能力,为具身智能及物理AI应用提供更强的技术支撑。
生数科技表示,世界模型的发展不仅是生成质量的提升,更是人工智能从生成内容走向理解世界、模拟世界和交互世界的过程。公司将持续推动基础模型能力突破,加速世界模型从数字内容生产向物理AI应用拓展。