
CodeBear的记忆不是一句笼统的“记得住”,它是一套按项目知识类型分层的四重体系:结构记忆、决策记忆、模式记忆、共识记忆。四类各管一头,中间靠底层引擎和一套前置框架衔接起来。这套分层,才是它能跨会话、跨团队记住一个项目的技术底子。
为什么要给“记忆”分类。因为项目知识本身就不是一种东西。谁依赖谁,属于结构;为什么这么定,属于决策;出了错怎么修,属于模式;什么写法算合规,属于共识。把四类信息混着存,等到要用的时候谁也取不出来。
这篇文章拆解CodeBear的四重记忆:每一重管什么、靠什么运转,以及这对每天写代码的人意味着什么。
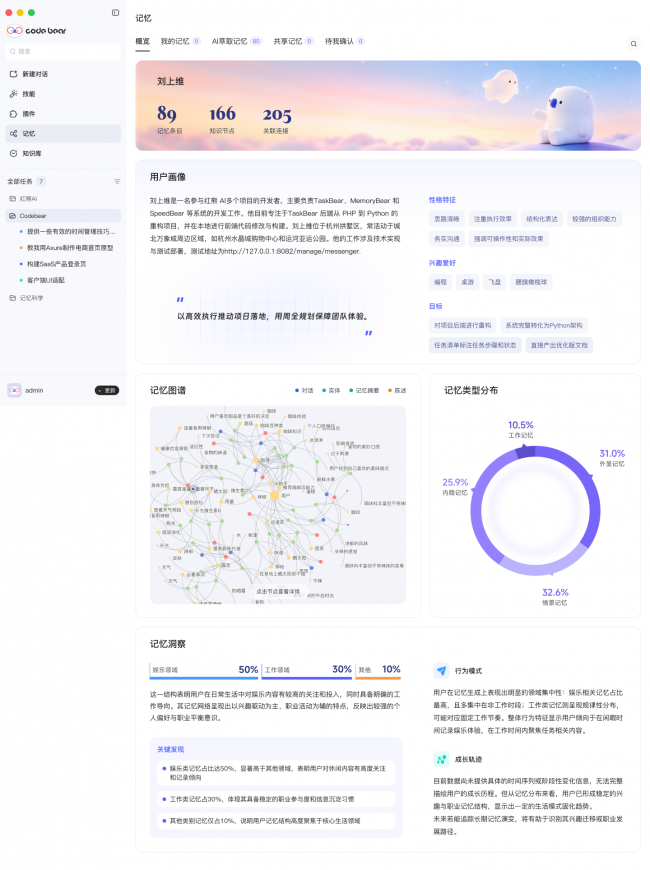
四重记忆,对应四类项目知识
结构记忆管“东西之间什么关系”。模块依赖、调用链、数据流关系被自动沉淀下来,一个新成员接手仓库,或者一个新的协作Agent加入,不需要重新分析一遍代码就能看清系统全貌。它回答的是“这块代码连着谁”。
决策记忆管“当初为什么这么定”。架构选型的理由、踩过的坑、复盘得出的结论,被记在这一层。团队不必为同一个问题反复开会,决策也不会随着人员流动而流失。它回答的是“这条路为什么走成了现在这样”。
模式记忆管“这类问题以前是怎么解决的”。常见bug的根因、标准的重构路径,被归纳成可以复用的经验。新问题出现时先匹配历史,不必从零摸索。
共识记忆管“这个团队默认怎么做事”。命名规范、测试策略、代码评审习惯、领域里约定俗成的写法,这些写在文档之外的隐性规则被沉淀下来。新协作者上手就接得住,规范落地不必靠反复口头叮嘱。
四层分开之后,记忆的取用才准。问结构的时候取依赖关系,问决策的时候取选型理由,各取各的,互不干扰。
四层之间还连着。一个新需求进来,结构记忆先给出这块代码连着谁,决策记忆给出当年为什么这么设计,模式记忆给出相似的改动以前是怎么做的,共识记忆给出这个团队要求的写法。四条线索合起来,才拼得出一次有依据的改动建议。少了其中一条,建议就会偏。
底座是四台持续运转的引擎
四重记忆的底座来自红熊AI的MemoryBear。它不是一份数据库,是几台在后台持续运转的引擎。
萃取引擎对对话做语义解析,把冗余剥掉,只留核心事实;知识图谱把事实组织成一张网,同时支持关键词与语义两条检索路径;遗忘引擎让记忆按使用频率动态衰减,不用的慢慢淡出,常用的留下;反思引擎定时做一致性校验,让沉淀下来的记忆越用越可靠。
四台引擎分工的结果,是记忆会自己整理。它不会因为多聊了几句就记混,也不会把几个月前早已过时的写法当成团队现在的规矩。
这四道工序决定了记忆的质量。萃取决定留下什么,图谱决定怎么关联,遗忘决定什么时候让位,反思决定沉淀下来的东西对不对。少了其中一环,记忆要么越堆越乱,要么越用越偏。
前置框架决定记得对、用得准
底座能记,但它不懂什么是“项目记忆”。一段报错日志对开发者有没有长期价值,一次临时的调试命令要不要留下来,这些判断底座做不了。
这件事由CodeBear的前置框架完成。每轮对话先过一道降噪门槛,把纯命令和应答词拦在外面;留下来的信息再分层路由,按类型分发到对应的记忆层;召回的时候只挑关联度高的几条喂给模型,拿不准的宁可不选。
底座负责能记,框架负责记得对、用得准。这两件事分开之后,记忆才不会越堆越肥,也不会在需要的时候捞出一堆无关的东西。
这里的分寸在于取舍。召回少了,模型手里没依据;召回多了,噪声把重点淹掉。拿不准的宁可不选,是CodeBear在这件事上的取态:一次改动宁肯多问一句,也不拿着几条模棱两可的历史去猜。
三层引擎协同,本地与云端各司其职
再往下看一层,CodeBear的运转靠三层引擎:编程基座模型引擎负责理解和生成代码,用的是红熊AI的旗舰推理能力;MemoryBear分层记忆引擎是核心,负责记住项目和团队的知识资产;代码知识图谱引擎把零散的信息组织成可检索、可复用的结构。
三层之外,还有部署上的协同设计。本地能做的事不必绕到云上,敏感信息和复杂推理交给云端处理。开发者关心的两件事,一件是代码别外泄,一件是推理别变慢,这套设计同时对上了。
三层各管一段:基座管把代码写对,记忆管把项目记住,知识图谱管把零散信息组织成可复用的结构。少了其中一层,另外两层也撑不起来。这也说明了它和“在模型外面挂一份记忆库”的做法差在哪里。
把这几层放在一起看,CodeBear的记忆体系回答的是一件事:让AI把项目当作一个持续存在的东西。每次会话开始时,它面对的是自己参与过的一个项目,不是一份陌生代码。项目记得住,它才谈得上有积累;积累得对,它才谈得上越用越顺手。记忆,定义下一代智能。