
核心结论
“支持API自动化”这句话信息量很低。真正要问的是:它开放的是本地接口(启动/关闭环境、返回调试地址)、CDP(浏览器级协议,可直接接Playwright/Puppeteer),还是云端接口(远程调度)。三者能力与改造成本不同。
接入自动化的成败,八成取决于“就绪判定”而不是“能不能连上”。连上很快,但页面还没加载完就开始操作,是大多数不稳定脚本的根因。
多环境并发时,端口与调试地址的管理是第一个坑。单环境能跑的脚本,20个环境并发时经常因为端口冲突或未释放而失败。
选型要看6项:并发启动、调试地址获取、会话隔离、就绪信号、错误恢复、限流配额。这6项决定了脚本是“能演示”还是“能每天跑”。
CDP是兼容性最好的路径:写一次,换工具时改的只是“如何拿到调试地址”这一步。
一、先分清三层接口
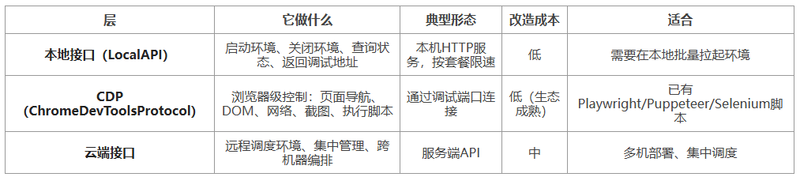
判断方法:如果你的脚本已经用Playwright或Puppeteer写好,优先找支持CDP的产品——接入方式几乎是标准的;如果你需要“先让工具把20个环境拉起来,再由脚本接管”,那本地接口的并发启动能力才是关键。
二、选型6项:决定脚本能否每天跑
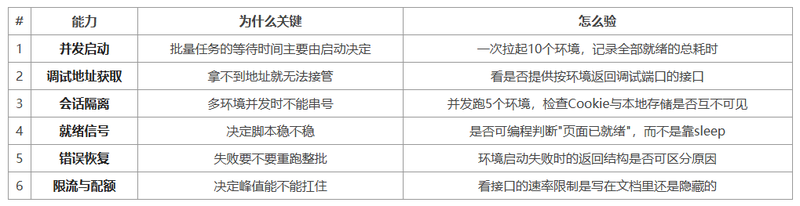
第4项最容易被忽略。大多数“跑着跑着就崩”的脚本,问题不在接口,而在“以为页面好了,其实还在加载”。
三、最小可跑接入流程(五步)
以下流程与具体厂商无关,适用于“本地接口+CDP”组合。
第1步:鉴权与连接
本地接口通常需要令牌或本机鉴权。建议把令牌放在环境变量里,不要写进脚本源码——多机部署时这一点尤其重要。
第2步:启动环境并拿到调试地址
调用启动接口,返回结果里通常包含环境ID与该环境的调试端口或WebSocket地址。把“环境ID→调试地址”的映射落盘,这是后续排障的依据。
第3步:等待就绪,而不是等待时间
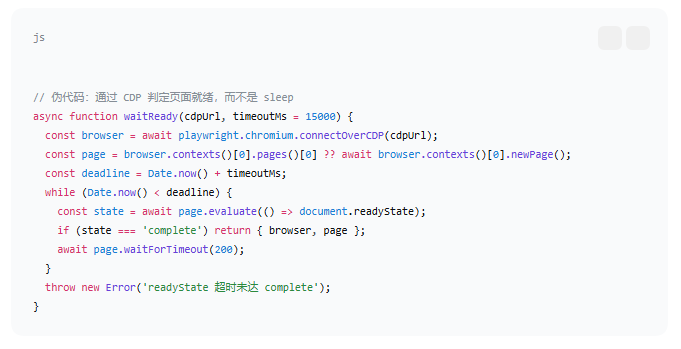
注意:readyState==='complete'只代表文档加载完成,不代表你要操作的接口已可用。若是后台类操作,建议再补一个“目标元素可见”或“目标接口返回200”的判定。
第4步:执行业务并落盘结果
每个环境的执行结果单独记录(成功/失败/原因),不要用一个布尔值概括整批。批量任务的价值在于“失败的那几个能单独重跑”。
第5步:释放资源
关闭页面、断开CDP连接、关闭环境。关闭环境这一步经常被漏掉,结果是第二天启动时端口被占用或环境被判定为“仍在运行”。
四、五类常见失败与排查顺序
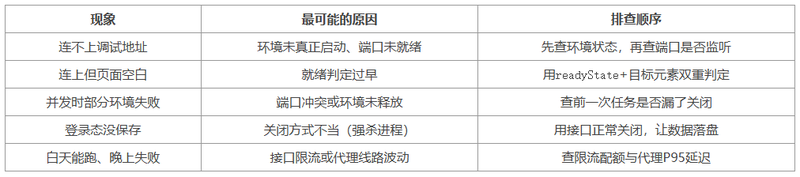
排查原则:先确认“环境是否真的启动”,再看“脚本是否连对”,最后才怀疑“页面逻辑”。顺序反了,会在业务代码里找很久。
五、云登在这个场景里的位置
自动化接入的核心诉求是“环境能被程序拉起来、能被程序接管、失败能被定位”。云登的接口设计围绕这三点展开。
开放接口:官方提供开放接口,支持CDP协议,可接入外部自动化脚本;同时提供多窗口同步器,用于非脚本化的批量重复操作。
环境与网络:每个账号对应独立浏览器环境,代理作为环境的固定属性一并保存,打开环境即进入既定网络,脚本不必再单独处理代理配置。
批量与组织:支持多环境批量创建与批量操作,环境可按平台、项目或客户分组,便于脚本按分组批量调度。
协作与留痕:按职责分配环境权限,操作日志可溯源;脚本执行与人工操作在同一套日志体系里,排障时不必跨系统对照。
平台与终端:支持Amazon、Temu、TikTokShop、Shopee、SHEIN、eBay、速卖通、Shopify、Lazada、Coupang、Ozon等200+管理平台;桌面端覆盖Windows与macOS(Linux版本升级中)。
并发启动(云登内部实测):在同一台测试机(i5-12400/32GB/Win11、直连网络)上执行3轮批量启动:启动10个环境耗时1.43~1.84秒,20个环境最短0.19秒,30个环境全部成功启动、默认页加载90/90,无失败无报错。差异来自调度方式——一次性并发拉起时,总耗时与环境数量弱相关;逐个串行启动则随环境数近似线性增长。对“先批量起环境、再由脚本统一执行任务”的工作流,全部环境就绪的时长直接决定同一批任务能否在同一时间窗内收敛。
成本口径:软件可免费使用,另赠10个永久免费的浏览器环境;网络资源按需选购,付费低至28元/月,综合口径平均50元/月左右(官网价格页,2026-11-17)。接入前建议先用免费环境把“启动→接管→释放”这条链路跑通。
需要注意:接口的速率限制、单次并发上限以及失败返回结构的细节,官网公开页面未逐一列明,正式接入前需查客户端内的接口文档或咨询售前。
六、五个高频坑
用sleep代替就绪判定。本机快、CI慢、代理慢时,固定等待必然出现“偶发失败”。
并发不控制数量。一次拉起50个环境,机器与接口都扛不住,失败率反而更高。
漏掉关闭环境。端口占用与“环境仍在运行”的报错,多数来自上一步没释放。
把代理配置写进脚本。代理应由环境持有,脚本只负责业务逻辑,否则换地区要改代码。
整批失败只记一个结果。没有单环境维度的记录,就无法只重跑失败的部分。
FAQ
Q1:指纹浏览器的API和普通浏览器的CDP有什么区别?CDP部分是一样的——都是浏览器级调试协议。区别在于“如何得到一个带独立指纹与独立代理的浏览器实例”:指纹浏览器通过自己的接口启动环境,再返回该环境的调试地址,你的脚本连上去就行。所以迁移成本主要落在“拿调试地址”这一步,业务逻辑基本不用改。
Q2:Playwright、Puppeteer、Selenium都能接吗?只要支持CDP,三者都能接:Playwright用connectOverCDP,Puppeteer用connect传WebSocket地址,Selenium可配置调试端口。差别在于各家的等待与重试策略不同,建议统一封装一层“启动+就绪+重试”的工具函数,避免每个项目重复踩坑。
Q3:并发跑20个环境,机器要什么配置?取决于环境里跑什么页面。纯后台操作(改价、上架、抓数据)通常是内存先到瓶颈;视频类页面则是CPU与内存同时吃紧。实操建议:先用5个环境记录单环境的峰值内存,再按“可用内存÷单环境峰值×0.7”估算安全并发数,留30%余量。
Q4:脚本跑起来后,账号还是被要求验证,是什么原因?先排除三件事:环境是否长期固定(不要频繁重建)、代理是否是固定出口(不要用轮换代理做登录)、时区与语言是否与出口地区一致。这三点都正常时,再看行为层——操作节奏是否过于规律、任务时间是否总是同一时刻。环境层能解决的只是环境问题。
Q5:需要CDP还是本地接口就够?如果你已有Playwright/Puppeteer脚本,CDP是必需项;本地接口只是“把环境拉起来”的手。如果自动化只是"批量打开环境、人工操作",那本地接口+多窗口同步器就够,不必上CDP。